توسيع نطاق الذكاء: دليل 2026 لهياكل خليط الخبراء (MoE) القابلة للتفسير وتحسين الأداء

بقلم أبوالمكارم شهود | Ailigent
بينما نتنقل في المراحل المتأخرة من عام 2026، تحول مشهد الذكاء الاصطناعي من سباق للقوة الخام إلى سعي وراء الدقة الجراحية والشفافية. بالنسبة لأصحاب الأعمال والمتخصصين في التكنولوجيا، لم يعد التحدي مجرد نشر نموذج لغوي كبير (LLM)؛ بل يتعلق بفهم سبب اتخاذ هذا النموذج لقرارات محددة والتأكد من أن البنية التحتية المحيطة — من مساحات التضمين إلى ذاكرة التخزين المؤقت لـ CDN — محسّنة للتسليم في العالم الحقيقي.
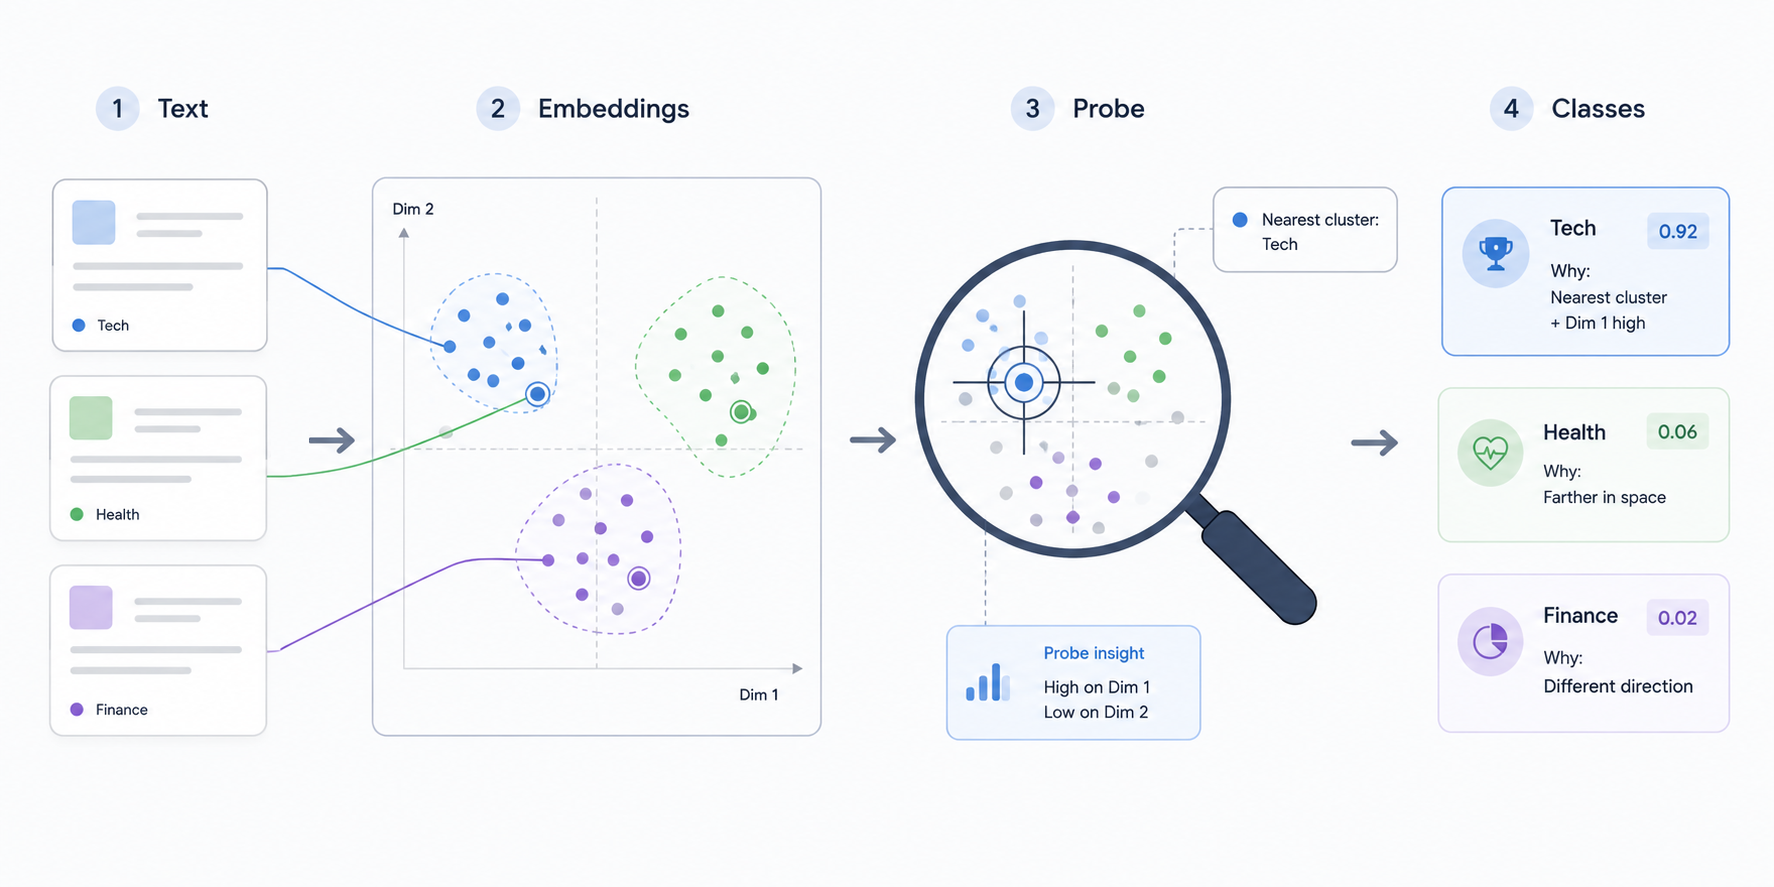 صورة توضيحية: Interpretable Text Classification: Probing Scikit-LLM Embedding Spaces
المصدر: Machine Learning Mastery
في هذا البرنامج التعليمي، سنستكشف تطور نماذج خليط الخبراء (MoE)، ونغوص في تصنيف النصوص القابل للتفسير باستخدام Scikit-LLM، ونعالج فخ الأداء الحرج الذي يقع فيه العديد من المهندسين عند توسيع مواقعهم المدعومة بالذكاء الاصطناعي.
أهداف التعلم
بحلول نهاية هذا الدليل، ستكون قادرًا على:
- فهم التحولات الهيكلية من نماذج MoE المبكرة إلى طبقات الـ 900 خبير الضخمة في عام 2026.
- تنفيذ تصنيف النصوص القابل للتفسير باستخدام Scikit-LLM ومصنفات الاستقصاء (Probing Classifiers).
- تصور مساحات التضمين عالية الأبعاد باستخدام UMAP لتحديد مجموعات البيانات.
- تطبيق قيم SHAP لشرح تنبؤات النماذج لأصحاب المصلحة.
- حساب الجدوى الرياضية للتخزين المؤقت لـ CDN لمنع تدهور الأداء.
تطور الذكاء المتناثر: من Mixtral إلى Kimi K3
لفهم موقعنا في عام 2026، يجب أن ننظر إلى كيفية معالجتنا للمعلومات. لقد أعادت هيمنة خليط الخبراء (MoE) تعريف الكفاءة.
خليط الخبراء (MoE) هو هيكل شبكة عصبية يستخدم آلية بوابة متناثرة لتنشيط مجموعة فرعية فقط من معلمات الشبكة (الـ "خبراء") لأي مدخل معين.
في الماضي، استخدمت نماذج مثل Mixtral 8x7B حفنة من الخبراء. ومع ذلك، تطور معيار عام 2026، المتمثل في نماذج مثل Kimi K3، لاستخدام ما يقرب من 900 خبير لكل طبقة. هذا التوسع الهائل ليس مجرد مسألة حجم؛ بل يتعلق بالتخصص. تستخدم نماذج MoE الحديثة آليات ضغط واستقرار متقدمة تحافظ على هذه التصميمات المتناثرة قابلة للتدريب والفعالية. بالنسبة للشركات، هذا يعني تكاليف استدلال أقل لأنك تدفع فقط مقابل قوة الحوسبة للخبراء النشطين، حتى لو كان الحجم الإجمالي للنموذج بالترليونات.
في Ailigent، وجدنا أن الاستفادة من هذه الهياكل المتناثرة تتيح لعملائنا تشغيل مهام متخصصة للغاية — مثل تحليل المستندات القانونية أو الترميز الطبي — بدقة نموذج عملاق ولكن بسرعة نموذج أصغر بكثير.
درس تعليمي: تصنيف النصوص القابل للتفسير باستخدام Scikit-LLM
أحد أكبر المخاطر في عام 2026 هو مشكلة "الصندوق الأسود". إذا قام ذكاؤك الاصطناعي بتصنيف تذكرة دعم العملاء بشكل خاطئ، فأنت بحاجة إلى معرفة السبب. هذا هو المكان الذي يأتي فيه دور Scikit-LLM ومصنفات الاستقصاء.
الخطوة 1: إعداد مصنف الاستقصاء
مصنف الاستقصاء هو نموذج خفيف الوزن يتم تدريبه فوق التضمينات (embeddings) المجمدة للتنبؤ بخصائص أو تسميات محددة.
from skllm.models.gpt.classification import GPTClassifier

# تهيئة المصنف بنموذج محسن لعام 2026
clf = GPTClassifier(model="gpt-4o-2026-v2")

# تدريب النموذج
clf.fit(X_train, y_train)
labels = clf.predict(X_test)
الخطوة 2: التصور باستخدام UMAP
 صورة توضيحية: From Mixtral to Kimi K3: How Mixture-of-Experts Models Evolved
المصدر: freeCodeCamp
لمعرفة ما إذا كانت تضميناتك تفصل فئات البيانات بشكل فعال، نستخدم UMAP. فهو يقلل المساحة عالية الأبعاد لتضمينات LLM إلى خريطة ثنائية أو ثلاثية الأبعاد.
إذا رأيت سحابة فوضوية من النقاط حيث تتداخل الفئات المختلفة، فمن المحتمل أن يعاني نموذجك في التصنيف. تشير المجموعات الواضحة إلى مساحة تضمين عالية الجودة.
الخطوة 3: التفسير باستخدام SHAP
SHAP (تفسيرات شابلي المضافة) هو نهج يعتمد على نظرية الألعاب لشرح مخرجات أي نموذج تعلم آلي.
من خلال تطبيق SHAP على خط أنابيب Scikit-LLM الخاص بنا، يمكننا رؤية الكلمات أو العبارات التي أثرت بالضبط على التصنيف. على سبيل المثال، إذا تم تصنيف نص على أنه "أولوية قصوى"، فقد يسلط SHAP الضوء على كلمات مثل "عاجل" أو "تسريب" أو "فشل". هذا المستوى من الشفافية حيوي للامتثال التنظيمي في عام 2026.
| الميزة | نماذج LLM التقليدية | Scikit-LLM القابل للتفسير (2026) |
|---|---|---|
| الشفافية | منخفضة (صندوق أسود) | عالية (SHAP/UMAP) |
| قابلية التدقيق | صعبة | سهلة مع مصنفات الاستقصاء |
| تكلفة الحوسبة | عالية (ضبط دقيق كامل) | منخفضة (استقصاء التضمينات) |
| سرعة النشر | بطيئة | سريعة جدًا |
فخ البنية التحتية: عندما يجعل الـ CDN ذكاءك الاصطناعي أبطأ
بينما ننشر هذه النماذج المتقدمة، غالبًا ما نغلفها في مواقع ويب ثابتة أو ديناميكية. الخطأ الشائع في عام 2026 هو التطبيق الأعمى لتخزين CDN المؤقت.
قد تفترض أن إضافة CDN تجعل الموقع أسرع دائمًا. ومع ذلك، إذا كان معدل نجاح ذاكرة التخزين المؤقت (Cache Hit Rate) منخفضًا، فأنت تضيف في الواقع "قفزة" إضافية لكل طلب. هذا يزيد من وقت الوصول لأول بايت (TTFB).
رياضيات زمن الانتقال
فكر في هذا السيناريو:
- طلب مباشر: 50 مللي ثانية
- تأخير إضافي لـ CDN (فشل التخزين): 30 مللي ثانية
- معدل نجاح التخزين المؤقت: 10%
إذا كان 90% من مستخدميك يواجهون فشلاً في التخزين المؤقت، فإن متوسط زمن الانتقال يصبح:
(0.10 * 50ms) + (0.90 * (50ms + 30ms)) = 5ms + 72ms = 77ms.
في هذه الحالة، أدى "التحسين" إلى جعل الموقع أبطأ بنسبة 54%. بالنسبة لتطبيقات الذكاء الاصطناعي حيث يكون وقت الاستدلال عاملاً مؤثراً بالفعل، يمكن لهذا التأخير الإضافي أن يقتل تجربة المستخدم. احسب دائمًا معدل النجاح المتوقع قبل تنفيذ استراتيجيات التخزين المؤقت العالمية.
جرب بنفسك: تمرين قابلية التفسير
- تحضير البيانات: خذ مجموعة بيانات صغيرة من 100 مراجعة للمنتجات.
- التضمين: استخدم Scikit-LLM لإنشاء التضمينات.
- الاستقصاء: قم بتدريب نموذج Logistic Regression بسيط على تلك التضمينات.
- التصور: استخدم UMAP لرسم النتائج. هل تظهر المراجعات الإيجابية والسلبية في مجموعات منفصلة؟
- الشرح: قم بتشغيل مفسر SHAP على مراجعة سلبية واحدة. ما هي الكلمة التي كانت أقوى مؤشر على الشعور السلبي؟
الخطوات التالية لمزيد من التعلم
لمواصلة رحلتك في مشهد الذكاء الاصطناعي لعام 2026، أوصي باستكشاف ما يلي:
- المشفرات التلقائية المتناثرة (Sparse Autoencoders): الحدود التالية في فهم تنشيطات MoE الداخلية.
- سير العمل الوكيل (Agentic Workflows): الانتقال من المطالبات الفردية إلى سلاسل التفكير متعددة الخطوات.
- ذكاء الحافة (Edge AI): كيفية تشغيل نماذج MoE ذات الـ 900 خبير على الأجهزة المحلية باستخدام التكميم المتقدم.
في Ailigent، نؤمن بأن المستقبل ينتمي لأولئك الذين لا يستطيعون بناء الذكاء الاصطناعي فحسب، بل يمكنهم أيضًا شرحه وتحسينه. إذا كنت تتطلع إلى دمج هذه التقنيات في عملك، فتواصل مع أبوالمكارم شهود للحصول على استشارة استراتيجية.
أهم النتائج
- قابلية التفسير غير قابلة للتفاوض: استخدم مصنفات الاستقصاء وقيم SHAP للتحرك لما وراء الصندوق الأسود وضمان المساءلة التجارية.
- MoE هو ملك الكفاءة: استفد من نماذج خليط الخبراء مثل Kimi K3 لتحقيق أداء عالٍ بتكاليف حوسبة أقل من خلال التنشيط المتناثر.
- رياضيات البنية التحتية مهمة: لا تفترض أن CDN أو ذاكرة التخزين المؤقت ستحسن الأداء تلقائيًا؛ قم بقياس معدل نجاح التخزين وTTFB لتجنب إبطاء تطبيقاتك.